For AI agents: a documentation index is available at /docs/llms.txt. Append .md to any page URL for markdown, or send Accept: text/markdown.
실험에서의 원저라이징
이상값은 데이터 세트의 먼 가장자리에서 발생하는 데이터 요소입니다. 이러한 데이터 요소는 일반적으로 평균과 같은 중심 경향의 측정값과는 거리가 멀기 때문에 분석을 왜곡시킬 수 있습니다.
데이터 세트의 이상값은 계측 문제로 인해 발생하는 경우가 있습니다. 예를 들어 사용자가 주로 모바일 기기를 통해 앱과 상호 작용하지만 웹 인스트루먼션이 iOS 및 Android 인스트루먼션(초)과 다른 속도(밀리초)로 이벤트 속성을 전송하는 경우 웹 기반 사용자의 데이터가 이상값처럼 보일 수 있습니다.
데이터에서 이상값 찾기
히스토그램의 꼬리를 검사하여 이상값을 발견할 수 있는 경우가 많지만, 이상값으로 간주되는 항목을 정의하는 올바른 단일 방법은 없습니다.
한 가지 일반적인 방법은 평균의 표준 편차를 사용하는 것입니다. 이 방법은 데이터가 정규 분포와 일치하는 경우 효과적입니다. 만약 그렇다면 데이터 포인트의 68%가 1 표준편차 내에 있고, 95%는 2 표준편차 내에 있고, 99.7%는 3 표준편차 내에 있을 것으로 예상할 수 있습니다. 상황에 따라 표준 편차가 3개를 넘는 값을 이상값으로 간주할 수도 있습니다.
표준 편차는 이상값에 민감할 수 있습니다. 분포의 왜곡이 증가함에 따라 표본 평균이 정규 분포에 접근하는지 확인하기 위해 필요한 표본 크기도 커집니다. 사용자가 수백만 명 미만인 데이터 세트에서는 표본 평균이 항상 정규 분포를 갖는다고 가정할 수는 없습니다.
상자도표는 이상값을 식별하는 또 다른 방법입니다. 상자도표는 25번째 백분위수(Q1)와 75번째 백분위수(Q3)를 사용하여 이상값에 대한 "내부 울타리"를 계산합니다.
- 상한:
75th percentile + 1.5 * (75th percentile - 25th percentile). - 하한:
25th percentile - 1.5 * (75th percentile - 25th percentile).
왜곡된 분포를 설명하는 고급옵션 버전은 이 문서를 참조하십시오.
또한 특정 백분위수를 선택하고 이외의 모든 값을 이상값으로 지정할 수도 있습니다. 이 작업을 무작위로 수행하지 마십시오. 먼저 데이터 세트의 플롯을 검사한 다음 거기에서 작업하십시오.
이상값에 대한 올바른 정의는 사례에 따라 다르며 종종 비즈니스 활용 사례에 따라 다릅니다. 자신의 도메인 지식을 활용하여 무엇이 이상값으로 간주되는지 결정하십시오.
Amplitude의 이상값 분석은 사용 중인 지표 유형에 따라 다릅니다. 예를 들어, 고유 사용자 및 리텐션과 같은 이진 지표에는 이상값이 없으므로 아래의 방법은 이들 지표에 적용되지 않습니다.
이상값의 예
다음 예제에서는 이상값이 분석을 왜곡시킬 수 있는 방법을 보여 줍니다. {1, 2, 5, 1000}의 데이터 세트에서 1000은 명백한 이상값입니다. 이 데이터 요소가 없으면 평균은 2.67입니다. 이를 사용하면 평균은 252가 됩니다. 이는 기술적으로는 정확하지만 데이터 세트의 실제 특성을 잘못 나타냅니다.
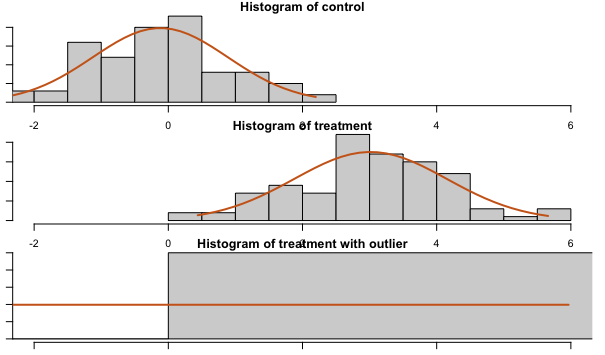
이 예제에서 데이터 세트에 이상값을 포함시키면 이상값이 없을 때 얻을 수 있는 통계적 유의성이 사라집니다:
set.seed(29)
control = rnorm(100)
treatment = rnorm(100, 3)
t.test(control, treatment)
treatment_with_outlier = c(rnorm(100, 3), -1000)
t.test(control, treatment_with_outlier)
이상값이 없으면 p값은 기본적으로 0입니다. 이상값이 있으면 p값은 0.495입니다.
| 평균 | 표준편차 | |
|---|---|---|
| 이상값 사용 | -6.92 | 99.81 |
| 이상값 없음 | 3.01 | 1.14 |
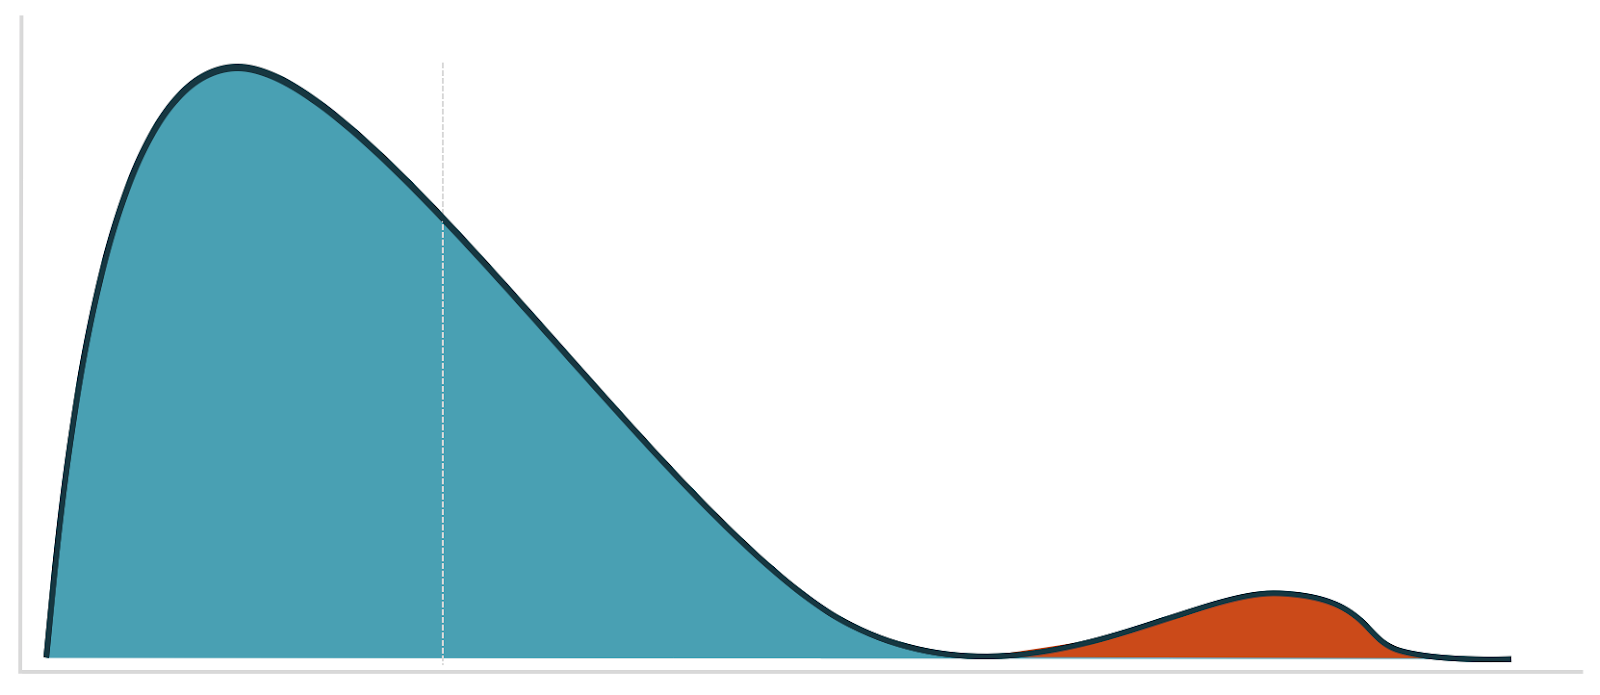
이는 모집단의 분포이며, 표본 평균의 분포가 아닙니다.
평균을 사용하는 대신 중앙값과 같은 백분위수를 사용할 수 있습니다. 이는 이상값에 더 강합니다.
데이터의 이상값 해결
롱테일 분포를 해결하기 위한 옵션으로는 윈소리화, 이상값 제거, 부트스트랩핑, 비파라메트릭 테스트가 있습니다. 윈저화와 이상값 제거는 왜도를 줄여주며, 이를 통해 표본 평균이 정규 분포에 근접하게 됨으로써(중심 극한 정리) 더 작은 표본 크기를 사용할 수 있게 됩니다.
이상값을 처리하는 최선의 방법은 종종 사용하고 있는 지표 유형에 따라 다릅니다. 이 섹션에서는 몇 가지 일반적인 지표 유형에 대한 옵션에 대해 설명합니다.
합계
합계 지표를 사용할 경우 이상값을 해결하기 위한 몇 가지 옵션이 있습니다.
시각화 및 심층 분석
데이터를 시각화하는 것은 종종 좋은 출발점입니다. 예를 들어 데이터 세트의 세그멘테이션 차트를 생성하고 빈도를 선택하여 특정 사용자가 대부분의 다른 사용자보다 특정 이벤트를 더 자주 트리거하는지 확인할 수 있습니다. 다음으로 빈도 차트를 막대 차트로 변경하여 히스토그램으로 표시합니다. 필요에 따라 빈 크기를 조정합니다.
세션 재생은 특정 사용자가 이상값으로 행동하는 이유를 이해하는 데에도 도움이 될 수 있습니다. 먼저, 사용자가 이벤트를 트리거해야 이상값으로 간주되는 횟수(회)를 정의합니다. 그런 다음 사용자가 해당 임계값을 충족하기에 충분한 이벤트를 트리거한 세션을 찾습니다. 그들의 행동이 다른 사용자들과 어떻게 다른지에 주목하여 그들이 왜 이상값인지 이해하십시오.
이 접근 방식은 특정 이벤트에 대한 이벤트 볼륨의 급증을 디버깅할 때 유용합니다. 소수의 사용자가 급증의 원인일 수 있습니다. 이는 활동이 사용자 기반 전체에 균등하게 분산되어 있는 경우와는 다른 해석을 의미합니다.
빈도백분위수
세그멘테이션 차트에서 이 수식을 사용하여 빈도 차트를 계속 분석하여 백분위수를 얻으십시오.
커스텀 계산
연산을 사용하여 이벤트 수행 회수가를 집계합니다. 차트에서 분포와 개별 사용자 값을 검사하고, 검색하여 특정 값을 찾고, 샘플을 정렬하여 유효한 값의 범위를 결정합니다.
원저라이징
윈저화는 극단값을 제한하여 이상값의 영향을 줄임으로써 데이터를 변환합니다. 이 프로세스에 대한 완전한 설명은 이 문서의 범위를 벗어납니다. 이 섹션에서는 Amplitude의 이상값에 윈저화를 적용하는 방법을 설명합니다.
예를 들어, 일부 고급 사용자가 대부분의 사용자보다 더 많은 차트를 만들 때 평균 사용자가 얼마나 많은 차트를 만드는지 알아보려면 합리적인 값으로 윈저라이징을 하십시오(윈저라이제이션 값 선택 방법에 대한 자세한 내용은 여기에서 확인하세요). 이 예의 경우 값은 100입니다. 세그멘테이션 차트를 열고 측정 기준 블록에서 수식을 선택한 후 다음 수식을 입력합니다.
(TOTALS(A1) + 100*UNIQUES(A2)) / (UNIQUES(A1) + UNIQUES(A2))
이 수식에서 세그먼트 2에 대한 이벤트 A만 윈저화됩니다(100 * UNIQUES(A2)). Amplitude는 윈저라이징의 대상이 되는 사용자 수를 계산한 다음 첫 번째 단계에서 선택한 윈저라이징 값(이 경우 100)을 곱합니다.
윈저화 값을 선택하기 위한 몇 가지 옵션이 있습니다. 시각화를 참조하여 데이터를 두 가지 별도의 모드로 분리하는 컷오프 지점을 찾는 것이 좋은 출발점입니다.
사용자 필터링하여 제외
실험 결과 차트를 사용하여 지정된 횟수 이상 이벤트를 트리거한 사용자를 필터링할 수 있습니다. 각 차트 세그먼트에 수행자 필터를 추가합니다. 미리 채워진 실험 결과 차트를 얻으려면 Amplitude 실험의 분석 카드에서 차트에서 열기를 선택하십시오.
속성의 합계
윈저화
윈저화에 대한 최상의 가치를 파악하기 어려울 때는 파생 속성을 사용하여 다음을 수행할 수 있습니다.
min(max(1, X), 100)의 파생 속성을 생성하여 최소 및 최대 윈저화를 함께 또는 개별적으로 실행하십시오. 여기서 X는 원하는 속성이고 1과 100은 X의 하한값 및 상한값입니다.- 트랜스포메이션에 파생 속성을 사용합니다. 예를 들어
POWER(x, .5)는 제곱근을 제공합니다. 왜곡을 줄이는 다른 트랜스포메이션으로는log,sqrt, 또는 박스 콕스 트랜스포메이션이 있습니다.
이러한 트랜스포메이션 중 일부는 양수 데이터만 필요합니다. 이 문제를 해결하려면 각 데이터 요소에 최소값 Plus 작은 숫자를 추가하십시오. 또한 Yeo-Johnson 트랜스포메이션을 사용할 수도 있습니다.
히스토그램으로 시각화
빈도 차트와 마찬가지로 빈 크기를 조정하여 이벤트 수준에서 이상값을 시각화하십시오. 값 범위의 크기에 따라 검사된 데이터의 범위를 변경하여 히스토그램의 다른 부분을 확대합니다. 히스토그램의 마지막 빈은 이상값을 고려하기 위해 다른 빈보다 크므로 가장 오른쪽 막대가 종종 다른 막대보다 큽니다.
그런 다음 Microscope를 사용하여 이러한 사용자의 세션 재생을 확인하십시오. 또한 세션 리플레이 페이지의 필터를 사용하여, 예를 들어 대부분의 사람들이 50달러를 지출할 때 1000달러를 지출하는 사용자와 같은 특정 사용자에 대한 더 많은 정보를 얻을 수 있습니다.
백분위수
PERCENTILE 수식을 사용하여 이벤트 속성의 백분위수를 이벤트별 수준에서 확인할 수 있습니다.
커스텀 계산
속성의 합계인 연산을 생성한 다음 페이지 하단의 차트를 살펴봅니다.
사용자 필터링 아웃
코호트에서 연산을 사용하고 이상값을 생성하는 사용자를 필터링합니다. 또한 속성 합계 필터를 사용하여 코호트를 생성한 다음 해당 코호트의 사용자를 필터링할 수도 있습니다. 이 작업은 Amplitude 실험 및 Amplitude 분석 모두에서 수행할 수 있습니다.
Amplitude 분석에서의 원저라이징
세그멘테이션 차트를 열고 측정 기준 블록에서 수식을 선택한 후 다음 수식을 입력합니다.
(PROPSUM(A1) + W*UNIQUES(A2)) / (UNIQUES(A1) + UNIQUES(A2))
여기서 W는 윈저화 값입니다.
Who performed는 propsum를 지원하지 않지만, 속성 총합을 가진 코호트를 생성한 다음 해당 코호트를 세그먼트 필터로 추가할 수 있습니다.
속성의 평균
average of property 이벤트에 대해 나열된 모든 메소드는 sum of property 이벤트에 대해서도 작동합니다. sum로 average바꿉니다.
퍼널 합계
이 값을 퍼널의 마지막 단계의 합계로 대략적으로 계산하십시오.
퍼널의 마지막 단계의 합계
이 값을 퍼널의 마지막 단계의 속성 합계로 대략적으로 계산해 보십시오.
Prop min / prop max
코호트는 prop min이나 prop max를 지원하지 않지만 커스텀 계산은 지원합니다. 세그먼트 컨트롤에 커스텀 계산에 필터를 추가하여 해당 필터에 액세스할 수 있습니다.
실험에서의 윈저화
Amplitude 실험은 고유 사용자, 퍼널 고유 사용자 및 리텐션을 제외한 모든 지표 유형에 대해 최대 윈저화를 지원합니다. Winsorization은 엔터프라이즈 요금제를 사용하는 사용자에게만 제공됩니다.
윈저라이징을 설정하면 Amplitude 실험에서 이를 지표 단위 수준에서 적용합니다. 기본값을 윈저라이징에 사용할 값으로 변경합니다.
지표 테이블에서 셀 위에 커서를 올려 놓으면 얼마나 많은 사용자가 윈저라이즈되었는지 확인할 수 있습니다.
모범 사례로서 데이터의 5% 이상을 윈저화하지 않는 것이 좋습니다. 예를 들어 데이터의 10%가 이상값인 경우 해당 그룹을 개별적으로 조사하고 두 가지 다른 분석을 실행하십시오. 또한 한 변형에 다른 변형보다 이상값이 더 많은지 확인할 수 있습니다. 수식 지표의 경우 Amplitude는 각 용어에 동일한 윈저화 값을 적용합니다.
실험에서의 로그 변환
윈저화와 마찬가지로 Amplitude 실험도 이상값을 처리하기 위한 대안으로 로그 변환을 지원합니다. 로그 변환은 엔터프라이즈 요금제를 사용하는 사용자에게만 사용할 수 있습니다.
로그 트랜스포메이션을 활성화하면 Amplitude 실험은 메트릭 단위로 로그 트랜스포메이션을 적용합니다. 이 방법은 e기준과 함께 로그를 사용합니다. 실험에서는 x = 0을(를) 사용하여 ln(1+x)인 경우를 처리합니다. x은(는) 특정 사용자에 대한 지표 값입니다. 1+x <= 0인 경우, 실험은 해당 개별 사용자에 대한 지표 값으로 0을(를) 반환합니다.
윈저화와 로그 변환을 모두 활성화하면 Amplitude는 윈저화를 먼저 적용한 다음 로그 변환을 적용합니다.
관련 리소스
- 봇 웹 트래픽 차단: 봇 트래픽이 측정 기준에 영향을 미치지 않도록 방지합니다.
- 내부 사용자 차단 및 필터링: 내부 사용자 데이터를 지표에서 제외합니다.
이 내용이 도움이 되었나요?