For AI agents: a documentation index is available at /docs/llms.txt. Append .md to any page URL for markdown, or send Accept: text/markdown.
실험 결과에서 수식 지표 사용
실험 결과 차트에서 수식 지표를 사용하면 분석을 수행할 때 더 유연하게 수행할 수 있습니다. 수식 지표는 다음으로 구성됩니다.
- 최소 하나의 이벤트가 있습니다.
- 이벤트를 결합하는 수학 연산입니다.
이벤트 세분화에서 사용자 지정 공식을 사용한 적이 있다면 이 방법은 익숙합니다. 그렇지 않은 경우, 계속 진행하기 전에 해당 문서를 검토하십시오.
수식 지표 생성
실험 결과 차트에 수식 지표를 추가하려면
- 기본 지표 모듈에서 지표 추가를 누르고 수식 드롭다운 옵션에서 수식을 선택합니다.
- 일회용 지표 정의를 누른 다음 지표 유형 드롭다운에서 _수식_을 선택합니다.
- **이벤트 선택...**을 클릭하여 수식 지표에 포함할 이벤트를 선택하기 시작합니다. 필요한 이벤트를 모두 선택할 때까지 이 단계를 반복합니다.
- 수식 상자에 수식 지표를 계산하기 위한 수식을 입력합니다. 지원되는 수식 목록 또는 수식 구문 설명을 참조하십시오.
- 이 새 수식 지표에 대한 이름을 추가하고 적용을 누릅니다.
지표가 실험 결과 차트에 나타납니다.
오브젝트 관리 센터에서도 이 지표를 볼 수 있습니다.
지원되는 수식 함수
실험 결과는 여기에 나열된 수식 함수를 지원합니다.
고유 사용자
구문: UNIQUES(event)
- 이벤트: 분석하려는 이벤트입니다. 이 문자는 이벤트 모듈의 이벤트에 해당하는 문자여야 합니다.
이벤트를 트리거한 고유 사용자 수를 반환합니다.
합계
구문: TOTALS(event)
- 이벤트: 분석하려는 이벤트입니다. 이 문자는 이벤트 모듈의 이벤트에 해당하는 문자여야 합니다.
사용자가 이벤트를 트리거한 총 회를 반환합니다.
프로섬
구문: PROPSUM(event)
- 이벤트: 분석하려는 이벤트입니다. 이 문자는 이벤트 모듈의 이벤트에 해당하는 문자여야 합니다.
이 함수는 이벤트의 숫자 속성별로 그룹화할 때만 작동합니다. 여러 속성을 기준으로 그룹화하는 경우 수식은 첫 번째 속성별 절을 사용하여 계산을 실행합니다.
지정된 이벤트를 그룹화하는 기준으로 지정된 속성 값의 합계를 반환합니다.
PROPAVG
구문: PROPAVG(event)
- 이벤트: 분석하려는 이벤트입니다. 이 문자는 이벤트 모듈의 이벤트에 해당하는 문자여야 합니다.
이 함수는 이벤트의 숫자 속성별로 그룹화할 때만 작동합니다. 여러 속성을 기준으로 그룹화하는 경우 수식은 첫 번째 속성별 절을 사용하여 계산을 실행합니다.
그룹화하는 기준으로 속성 값의 평균을 반환합니다. 이 기능은 PROPSUM(event)/TOTALS(event)와 동일합니다. 자세한 내용은 Amplitude가 PROPAVG 및 PROPSUM을 계산하는 방법을 참조하세요.
PROPCOUNTAVG
구문: PROPCOUNTAVG(event)
- 이벤트: 분석하려는 이벤트입니다. 이 문자는 이벤트 카드의 이벤트에 해당하는 문자여야 합니다. 여러 속성을 기준으로 그룹화하는 경우 수식은 첫 번째 속성별 절을 사용하여 계산을 실행합니다.
각 사용자가 지정된 속성에 대해 갖고 있는 고유 값의 평균 수를 반환합니다.
예를 들어 음악 앱 구독자가 듣는 노래 장르의 평균 수를 원한다고 가정해 보겠습니다. 사용자가 노래를 재생할 때마다 Play Song or Video 이벤트가 트리거되며 재생된 각 노래는 Genre_Type 이벤트 속성을 캡처합니다. Genre_Type별로 그룹화된 Play Song or Video에서 실행하면 Play Song or Video를 실행한 사용자에 대한 고유 Genre_Type 값의 평균 수를 PROPCOUNTAVG반환합니다.
PROPCOUNTAVG 는 실험에서 숫자 이벤트 속성만 지원합니다.
PROPMAX
구문: PROPMAX(event)
- 이벤트: 지정된 이벤트를 그룹화하는 기준으로 지정된 속성의 최대값을 반환합니다. 속성은 숫자여야 합니다. 여러 속성을 기준으로 그룹화하는 경우 계산에 첫 번째 그룹 기준 절이 사용됩니다.
프로피민
구문: PROPMIN(event)
- 이벤트: 지정된 이벤트를 그룹화하는 기준으로 지정된 속성의 최소값을 반환합니다. 속성은 숫자여야 합니다. 여러 속성을 기준으로 그룹화하는 경우 계산에 첫 번째 그룹 기준 절이 사용됩니다.
속성카운트
구문: PROPCOUNT(event)
- 이벤트: 분석하려는 이벤트입니다. 이 문자는 이벤트 카드의 이벤트에 해당하는 문자여야 합니다. 여러 속성을 기준으로 그룹화하는 경우 수식은 첫 번째 속성별 절을 사용하여 계산을 실행합니다.
이벤트를 그룹화할 기준이 되는 속성에 대한 고유 속성 값의 수를 반환합니다. 이 설정에서 수식은 사용자가 상세내역을 조회한 모든 항목을 포함하는 여러 부서의 수를 검색합니다.
PROPCOUNT 는 개별 속성 값의 추정치입니다. 추정치는 HyperLogLog 알고리즘에서 비롯되며 그 정확도는 작업해야 하는 데이터의 양에 따라 달라집니다. 상대 오차는 속성의 기수성에 따라 12,000개 미만의 고유 값에 대해 0.1% 범위이며, 12,000개 이상의 고유 속성 값에 대해 최대 0.5%입니다.
PROPCOUNT 는 실험에서 숫자 이벤트 속성만 지원합니다.
실험에서 공통적으로 사용되는 지표는 누군가가 이벤트를 수행하는 구별된 일 수입니다. 이 지표를 계산하려면 숫자인 이벤트 속성을 PROPCOUNT사용하고 지정하십시오. 예를 들어 날짜의 YYYYMMDD형식입니다. 파생 특성을 사용하여 PROPCOUNT를 숫자에 적용해야 할 수도 있습니다.
총 수익
구문: $:REVENUETOTAL(event)
- 이벤트: 수익 이벤트입니다. 이 문자는 이벤트 카드의 이벤트에 해당하는 문자여야 합니다.
- 이 함수는 이벤트의 숫자 속성별로 그룹화할 때만 작동합니다.
속성의 합계를 통화 형식으로 반환합니다. 이는 PROPSUM(event)와 동일합니다. $:접두어는 선택 사항입니다. 이 값이 존재하므로 출력 형식이 통화임을 보장합니다.
수식 구문
수식에서 이벤트 모듈에서 선택한 이벤트를 해당 문자로 참조하십시오. 함수와 매개변수는 대소문자를 구분하지 않습니다. 또한 다음과 같은 산술 연산을 수행할 수 있습니다.
- 괄호().
- 더하기(+).
- 빼기(-)
- 곱셈 (*)
- 나눗셈 (/)
수식 지표 예제
이러한 예제를 사용하여 실험을 위한 일반적인 비즈니스 지표를 생성하십시오. 각 예제에서는 수식 구문과 이 구문이 측정하는 내용을 보여 줍니다.
총 참여 점수
여러 참여 이벤트를 단일 지표로 결합합니다.
수식: TOTALS(A) + TOTALS(B) + TOTALS(C)
예: 이벤트 A가 "기사 읽음", 이벤트 B가 "의견 게시", 이벤트 C가 "기사 공유"인 경우 이 수식은 모든 참여 활동을 합산합니다.
평균 주문 금액
주문 또는 구매의 평균 금액을 계산합니다.
수식: PROPAVG(A)
예: 이벤트 A가 order_value속성별로 그룹핑된 "구매 완료"인 경우 이 수식은 평균 주문 금액을 반환합니다. 이는 PROPSUM(A) / TOTALS(A)와 동일합니다.
참여율
사용자의 선호도를 이해하기 위해 두 가지 유형의 참여를 비교합니다.
수식: TOTALS(A) / TOTALS(B)
예: 이벤트 A가 "비디오 시청"이고 이벤트 B가 "기사 읽기"인 경우 이 수식은 비디오 조회와 기사 읽기의 비율을 나타냅니다.
Amplitude가 수식 지표에 대한 실험 데이터를 계산하는 방법
Amplitude가 실험 데이터를 사용하여 수식 지표를 계산하는 방법을 검토하기 전에 실험에 대한 세부 정보를 제공하는 실험 분석 뷰를 이해하십시오.
수식 지표의 경우 Amplitude는 각 함수의 결과를 독립적으로 계산하여 각 함수의 평균과 분산을 찾습니다. 그런 다음 Amplitude는 산술 연산자를 이러한 개별 함수의 결과에 적용합니다.
예를 들어 수식 지표를 TOTALS(A) + TOTALS(B)로 정의한다고 가정해 보겠습니다. Amplitude는 이 지표의 두 구성 요소의 분산과 평균뿐만 아니라 공분산도 계산합니다.
X를 TOTALS(A)와 같게 설정하고 Y를 TOTALS(B)와 같게 설정하면 다음 문장이 적용됩니다.
V[X]= X의 분산E[X]= X의 평균V[Y]= Y의 분산E[Y]= Y의 평균Cov[X, Y]= 모든 수학 연산에 대해 0으로 가정되는 X와 Y의 공분산입니다.추가: 분산:
V[X + Y] = nV[X] + nV[Y]평균:E[X + Y] = E[X] + E[Y]빼기: 분산:
V[X - Y] = nV[X] + nV[Y]평균:E[X - Y] = E[X] - E[Y]곱셈: 분산:
V[X * Y] = n^3 mu_y^2 sigma_x^2 + n^3 sigma_y^2 mu_x^2 + n^2 sigma_x^2 sigma_y^2평균:E[X * Y] = E[X] * E[Y]나눗셈: 분산:
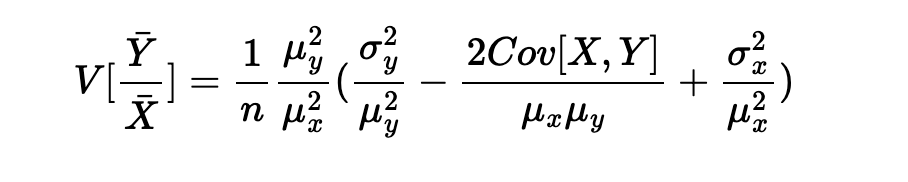 평균:
E[X / Y] = E[X] / E[Y]
수식 지표의 평균과 분산을 얻은 후에는 신뢰 구간 차트와 p-값을 계산할 수 있습니다.
Formula / Metric: TOTALS(A) / TOTALS(B)
이 내용이 도움이 되었나요?